POSTMAN BEST PRACTICES
APIオブザーバビリティ
Building quality APIs has never been more important. At Postman, we believe being API-first is the key to innovation in the AI era. We built Postman Best Practices to share the foundational ideas Postman is built on and enable you to do your best work.
多くのチームは、顧客からの報告で初めてAPI障害を知り、既存のダッシュボードではCPUスパイクなどのインフラ情報しか得られないという課題を抱えています。どのエンドポイントが失敗したのか、どんなエラーが発生しているのかを把握できず、再現にも時間がかかります。
ここでは、開発フローの中に継続的な監視と自動検出機能を組み込み、既存のテストを自動化して本番前に不具合を検出する方法を紹介します。さらに、実際のトラフィックからエンドポイントを自動特定し、実ユーザーデータを活用して問題を瞬時に再現する仕組みを構築します。
Abhinav Asthana
Postman CEO and Co-founder
Ankit Sobti
Postman Field CTO and Co-founder
多くのチームは、顧客からの報告で初めてAPIの問題に気づくという共通の課題を抱えています。問題が発生した際、ログをたどって原因を突き止めるまでに時間がかかり、その間にもユーザーへの影響は拡大していきます。
多くのエンジニアリングチームはすでにモニタリングを導入していますが、得られるデータを実際のアクションに結びつけることは容易ではありません。ダッシュボードには多くのメトリクスが並んでいても、CPUスパイクのようなインフラ指標だけでは「どのエンドポイントが失敗しているのか」「ユーザーがどんなエラーを見ているのか」「どう再現すればいいのか」までは分からないのです。
APIオブザーバビリティは、この問題を根本的に解決します。Postmanを使えば、開発ワークフローの中に継続的なヘルスモニタリングを組み込み、既存のテストやコレクションを自動的な観測システムとして活用できます。これにより、問題が起きた瞬間にコンテキストを把握し、再現・修正までを迅速に行うことが可能になります。
既存テストからのオブザーバビリティ構築
あなたのAPIテストには、すでに重要な観測シグナルが含まれています。探索的テスト、機能テスト、統合テスト、コントラクトテストのいずれも、APIの健全性に関する情報を生成しています。重要なのは、これらのデータを体系的に収集・分析し、時間経過による動作傾向を把握できる仕組みに変えることです。
実践ガイド
既存のテストコレクションを APIテスト自動化から継続的な監視ツールに変換し、定期的に実行されるようスケジュール設定します。その結果を、単なる「成功/失敗」ではなくヘルス傾向データとして分析します。
各テストタイプを継続的に実行することで、以下のような観測シグナルを得られます。
- 機能・スモークテスト:稼働状況と可用性の確認
- 統合テスト:依存サービスの健全性を継続的に検証
- エンドツーエンドワークフローテスト:実際のユーザージャーニー全体の信頼性を測定
- コントラクトテスト:互換性の問題や破壊的変更を早期に検出
- パフォーマンステスト:レイテンシやスループットの長期トレンドを追跡
このデータは単発のテスト結果よりも、時間的変化のパターンを見たときに最も価値を発揮します。単一のテスト失敗は一時的な環境要因である可能性がありますが、コントラクトテストの成功率が継続的に低下している場合は、互換性の問題が進行している明確な兆候です。
推奨プラクティス
- 既存のテスト検証ロジックに加えて、APIの健全性に関するアサーションを追加する。
- 環境変数を使って、開発・ステージング・本番などの各環境で同じオブザーバビリティコレクションを実行できるようにする。
- 成功率が徐々に低下している場合でも検知できるよう、トレンドベースのアラートを設定する。
- APIの重要度に応じてモニタリングの実行頻度を設定する。ユーザー向けの重要なAPIは5~15分ごと、社内サービスは1時間ごとに実行し、コントラクトの検証はデプロイのタイミングに合わせて行う。
- 外部モニタリングツールと連携し、ダッシュボード上で長期的な傾向分析や総合的な監視を行う。
APIそのものを継続的にモニタリングする
多くのAPI障害は、最初から大規模な停止として発生するわけではありません。ほとんどの場合、小さな回帰や劣化が徐々に進行し、気づかないうちにユーザーへ影響を与えるようになります。従来のシステム監視では、CPU使用率やメモリスパイクなどの症状は検知できても、APIそのものが正しく動作しているかまでは確認できません。そこで役立つのがPostmanモニターです。
モニターを使えば、Postmanコレクションを定期的またはオンデマンドで自動実行し、APIの健全性を直接検証できます。これにより、ユーザーに影響が出る前に問題を検出でき、リリースの信頼性を高めることができます。
- スケジュールモニターは、継続的なヘルスチェックとして機能します。定期的に実行され、稼働状況、依存関係、エンドツーエンドのワークフローを継続的に検証します。同じテストを開発・ステージング・本番環境で実行することで、単発の合否ではなく、健全性の傾向を把握できます。
- オンデマンドモニターは、リリースのたびに実行されるリアルタイム検証の仕組みです。次の定期実行を待たずに、CI/CDパイプライン内から直接起動できます。これにより、各リリースをリアルタイムで検証し、モニターを回帰を防ぐリリースゲートとして活用できます。
スケジュールモニターとオンデマンドモニターを併用すると、開発者は自分のコードをデプロイしても問題ないかをすぐに確認できます。その結果、運用チームやQAチームは本番環境での緊急対応を減らすことができ、管理者はリリースの安定性を高めながら、ロールバックやコンプライアンス違反のリスクを防げます。
この2種類のモニターを組み合わせることで、APIのライフサイクル全体を網羅できます。スケジュールモニターは継続的な稼働を保証し、オンデマンドモニターはリリース時の確信を与えてくれます。
Postman Insightsによる高度な分析
Postman Insightsは、開発者が本当に注目すべき「実際のユーザーによるAPIリクエスト」に焦点を当てることで、生産性を向上させます。インフラのメトリクスではなく、APIトラフィックを直接観測して、ユーザーに影響する問題をすぐに特定できます。これにより、クライアント/サーバーエラー(4xx/5xx)やレイテンシによるパフォーマンス低下など、APIエラーが原因のインシデントに対する平均解決時間(MTTR)を大幅に短縮できます。
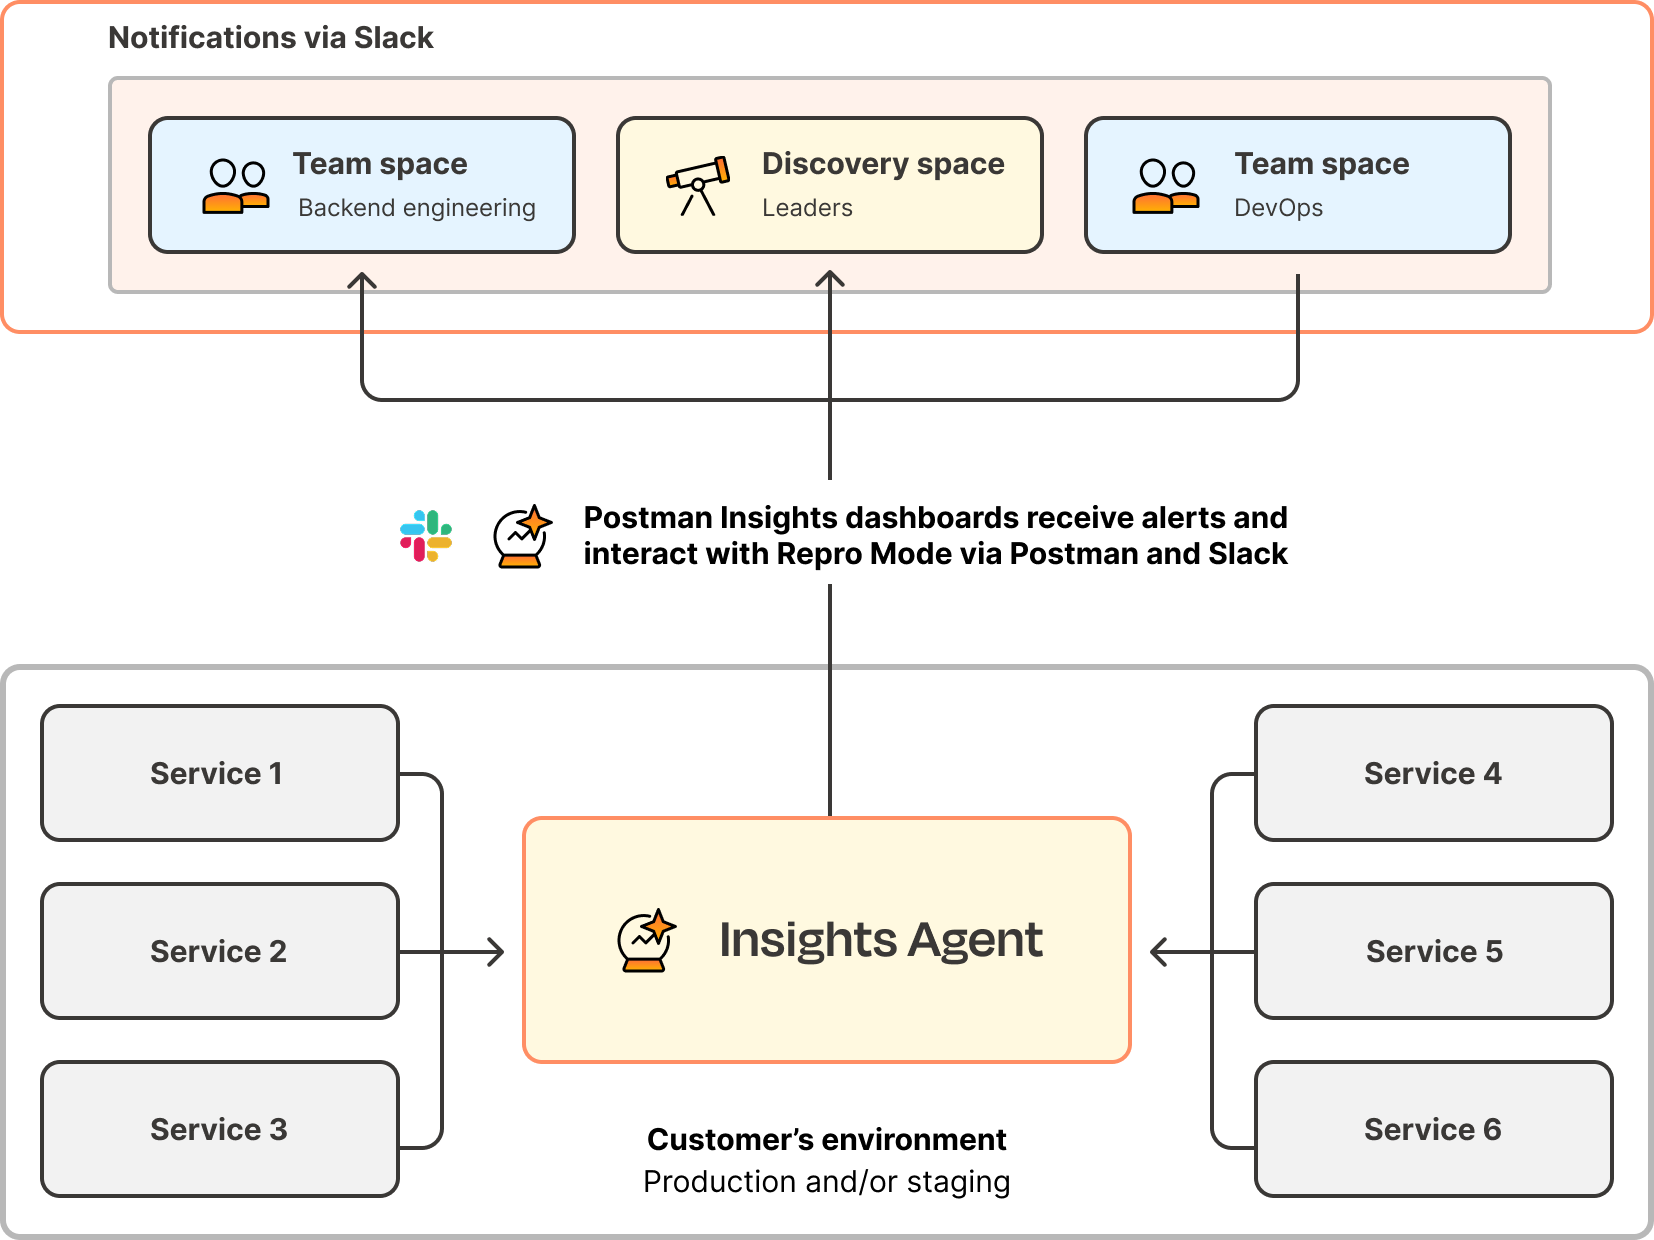
Postman InsightsにおけるAPIオブザーバビリティのパターン
PostmanのAPIオブザーバビリティで最も強力な機能は、Postman InsightsのRepro Modeです。この機能は、エラーが発生したAPIコールを自動的に記録し、すぐに実行できるPostmanリクエストに変換します。エラーが発生すると、チームは失敗の原因となった条件を即座に再現できます。リクエストビルダー内でこれらのリクエストをコレクションとして保存し、あらゆるコラボレーションワークフローで再利用することも可能です。
これにより、デバッグまでの時間を大幅に短縮し、開発者が問題を再現・修正するまでのプロセスを効率化します。
Postman InsightsをAPI Catalogに接続
Postman InsightsをAPI Catalogに接続すると、Insightsが取得したエラー率、シャドウエンドポイント、トラフィックパターンなどのデータが、各サービスのAPI Catalogビューに直接表示されます。プラットフォームエンジニアは、サービスの稼働状況を確認するために別のInsightsプロジェクトへ移動する必要はありません。各APIの仕様、テストカバレッジ、ガバナンスの適用状況とあわせて、1か所で確認できます。
また、API Catalogに表示される「シャドウエンドポイント」の情報もInsightsから直接提供されます。シャドウエンドポイントとは、実際にトラフィックを受けているものの、どのコレクションやAPI仕様にも含まれていないAPIです。API Catalogでシャドウエンドポイントが見つかったら、そのサービスを管理対象に追加するためのオンボーディングを開始します。
また、オブザーバビリティの活用方法は、チームの運用ニーズやサービスアーキテクチャによって異なります。
開発チームによるモニタリング:リアルタイムな問題検知
このパターンでは、開発チームが自分たちの担当サービスにPostman Insightsを導入し、APIの健全性をリアルタイムで把握します。チームはエラー発生時にすぐアラートを受け取り、問題をその場で特定・修正できます。さらに、Insightsで得られたデータをもとに、今後の開発優先度を決定したり、改善計画に反映させたりすることも可能です。
実践ガイド
Kubernetes、 ECS、EC2またはElastic Beanstalkを利用しているインフラ環境に応じた構成を選択し、Postmanのドキュメントに従って設定を行います。エラー率が通常値を超えた場合、チームのSlackチャンネルなどに自動通知されるようアラートを構成します。
推奨プラクティス- チームが担当する各サービスごとに、1つのInsightsプロジェクトを設定する。
- 5xxサーバーエラーのアラートを有効化し、障害発生時に即時通知を受け取れるようにする。
- Repro Modeを有効にして、失敗したリクエストを自動でキャプチャし、再現可能な形で保存する。
- Save to Collections機能を使い、失敗したシナリオを再利用可能なテストケースとして保存する。
- 毎週の振り返り(レトロスペクティブ)で、エラー傾向をレビューし、改善すべきパターンを特定する。
- マイクロサービスチーム:個々のサービスの健全性をモニタリングする。
- APIチーム:高い稼働率が求められるモバイルアプリケーションをサポートする。
- プラットフォームチーム:複数の内部利用チームに共有サービスを提供する。
運用チームによるモニタリング:サービス間の連携を見える化
複数のサービスにInsightsを導入して、APIの健全性をシステム全体で監視します。このパターンでは、サービス間の依存関係を理解し、発生したインシデントに対して複数チームが協力して対応できるようにすることを重視しています。
実践ガイド
まず、インフラ自動化を使って、重要なすべてのサービスにInsightsエージェント を導入します。次に、アラートのルーティングを設定して、各チームが自分の担当サービスの問題をすぐに把握できるようにします。同時に、運用チームがシステム全体の動きを俯瞰できるように可視化を有効化します。
推奨プラクティス
- すべての本番サービスにモニタリングを導入し、まずはユーザー向けAPIから開始する。
- アラートを適切なサービスオーナーへルーティングするエスカレーションポリシーを設定する。
- サービス間のエラー相関分析を活用して、カスケード障害を特定する。
- 検出されたエンドポイントをエクスポートし、正確なサービスカタログを維持する。
- 検出されたエンドポイントをエクスポートし、正確なサービスカタログを維持する。
- プラットフォーム信頼性チーム:マイクロサービスアーキテクチャ全体の稼働状況を管理する。
- DevOpsチーム:継続的デプロイメントパイプラインをサポートする。
- SREチーム(サイト信頼性エンジニアリング):システム全体の健全性を維持・監視する。
プロダクトチームによるモニタリング:ユーザー体験の検証
プロダクトチームは、Postman Insightsを使ってAPIパフォーマンスがユーザー体験に与える影響を把握します。APIエラーとユーザージャーニーの完了率や機能採用率との相関関係に焦点を当てています。
実践ガイド
ユーザー向け機能を直接支えるAPIに Insights をデプロイします。ユーザーに影響を与えるエラーに対してアラートを設定し、オブザーバビリティデータをプロダクト分析と統合して、APIの健全性とユーザー体験の関係を把握します。
推奨プラクティス
- サインアップ、チェックアウト、データアクセスなど、重要なユーザージャーニーを支えるAPIをモニターする。
- オンボーディング上の問題を示す可能性がある認証失敗のアラートを設定する。
- ユーザーセグメントや地域ごとのエラー傾向を追跡する。
- パフォーマンスデータを活用して、機能開発の優先順位や技術的負債の対応方針を判断する。
- APIの健全性メトリクスを定期レポートとしてプロダクト関係者に共有する。
代表的なユースケース:
- 新機能をリリースするプロダクトチーム:API連携に依存する機能の安定稼働を確認する。
- カスタマーサクセスチーム:ユーザー定着率に影響する技術的な問題を特定する。
- グロースチーム:複数のAPI呼び出しを伴うコンバージョンファネルを最適化する。
本番環境での障害対応
InsightsがAPI呼び出しの失敗を検知した場合、チームは通常次の手順で問題を解決します。
- Insightsで失敗したエンドポイントをクリックし、エラーの詳細と発生頻度を確認する。
- Repro Mode を使用して、失敗時のパラメータを自動入力したPostmanリクエストを生成する。
- リクエスト内容を修正し、レスポンスを確認して修正が有効かをテストする。
- このシナリオをコレクションとして保存し、デプロイ後の回帰(再発)を防止する。
- ワークスペースのリンクを使って失敗したリクエストをチームメンバーと共有し、共同でデバッグを行う。
ヒント:Insightsで検出した問題をAgent Modeですばやく切り分けましょう。Insightsでエラーが発生しているエンドポイントが見つかった場合、Insightsのデータ、コレクションの変更履歴、環境変数を手作業で照合しなくても、Agent Modeに自然言語で質問してエラーの原因を調査できます。プロンプト:「Insightsで、14:00以降にCheckout APIの500エラーが急増しています。同じ時間帯に、コレクションやAPI仕様に何か変更はありましたか?」Agent Modeは、API Catalog、Insightsのデータ、ワークスペースの変更履歴をまとめて確認できるため、複数のツールを行き来することなく、問題の原因を特定するまでの平均時間を短縮できます。
実際の利用データからテストカバレッジを構築する
Insightsのデータを使って、テスト戦略を改善します。
- 不足しているテストケースを発見する:InsightsのEndpointsタブを開き、既存のコレクションでカバーされていないエンドポイントをフィルタリングします。それらをコレクションとしてエクスポートし、テストの抜け漏れを補完します。
- 回帰テストを作成する:本番環境で発生した問題をRepro Modeで修正した際、その失敗シナリオをテストケースとして保存します。これにより、同じ問題が将来のリリースで再発することを防げます。
- 修正内容を本番で検証する:修正をデプロイした後、同じエンドポイントをInsightsで監視し、エラー率が低下し、安定していることを確認します。
未ドキュメントAPIの管理
Insightsは、トラフィックを受信しているすべてのAPIエンドポイントを自動的に検出します。これには、正式にドキュメント化されていないエンドポイントも含まれます。
- API全体を監査する:検出されたエンドポイントの一覧を確認し、ドキュメント化が必要なAPIや、非推奨とすべきAPIを特定します。
- ドキュメント化のためにエクスポートする:Save to Collectionsを使用して、検出されたエンドポイントからコレクションを作成します。その後、適切なドキュメントを追加して内容を整理します。
- モニタリングを設定する:重要な未ドキュメントAPIにモニターを追加し、長期的な扱いを決定する間も安定して動作していることを確認します。
モニターとInsightsを組み合わせることで、完全なオブザーバビリティが実現します。
- モニターは「起こるべきこと」(設計されたテストやスケジュール実行、デプロイ時の検証)を確認します。
- Insightsは「実際に起きていること」(実ユーザートラフィック、エラー、レイテンシ、再現シナリオ)を可視化します。
この組み合わせにより、チームは回帰を防ぎつつ、実際の障害にも迅速に対応できます。モニターで事前対策を行い、Insightsで実ユーザーの状況を把握することで、オブザーバビリティサイクルを完全に閉じることができます。
使いながら理解するのが一番です。Postman Insightsを始める →